系統總覽
四套系統,一次看懂差別
從你手上有的東西開始選:有錄音檔、有文字,還是想看懂一段族語。
系統一
語音辨識系統
將音檔轉錄為符合現行書寫規範的文字。
以 Kaldi 模型訓練,支援 16 族族語,上傳音檔即直接產出純文字。族語教學錄音、田野訪談都能先做出逐字稿初稿,再由族語老師校對。
- 16 族
- 全數支援
- < 10%
- 16 族 CER
- 純文字
- 輸出格式
系統二
逐字稿辨識系統
簡化繁瑣的人工作業,加速語料的保存。
以 Whisper Large 模型訓練,支援 16 族族語,輸出 SRT 字幕檔,每句都帶有起訖時間。語推組織與族語老師製作教學影片時,可直接匯入剪輯軟體,省下逐句對時間軸的功夫。
- 16 族
- 全數支援
- SRT
- 字幕檔格式
- Whisper
- Large 模型
系統三
語音合成系統
將族語文字轉錄為擬真發音,如實呈現。
以 F5-TTS 模型訓練,支援 16 族 42 語別。「預設配音員」輸入文字就能合成;「自己當配音員」錄一段指定句子,系統就用你的聲音唸出族語文字。太魯閣語、秀姑巒阿美語、德固達雅賽德克語族語老師進行的 MOS 盲測中,機器合成分數 4.49–4.84,與同批真人錄音的 4.48–4.92 相當接近。
- 42 語別
- 全數支援
- > 4.49
- MOS 分數
- 2 種
- 預設/自己當配音員
系統四
基礎翻譯系統
族語和華語對譯,成為溝通學習的工具。
以 Meta AI 的 NLLB-200 模型為基礎訓練,支援 16 族 42 語別雙向互翻,訓練語料累計 84 萬句、3,289 萬字元。它是「基礎」翻譯系統,適合快速理解一段族語的意思或產出翻譯初稿,正式使用前建議請族語老師確認。
- 84 萬句
- 訓練語料句數
- 3,289 萬
- 訓練語料字元數
- 雙向
- 族語 ⇄ 華語
計畫成果
MINANAM 科技 x 語言
112-114 族語 AI 成果發表會
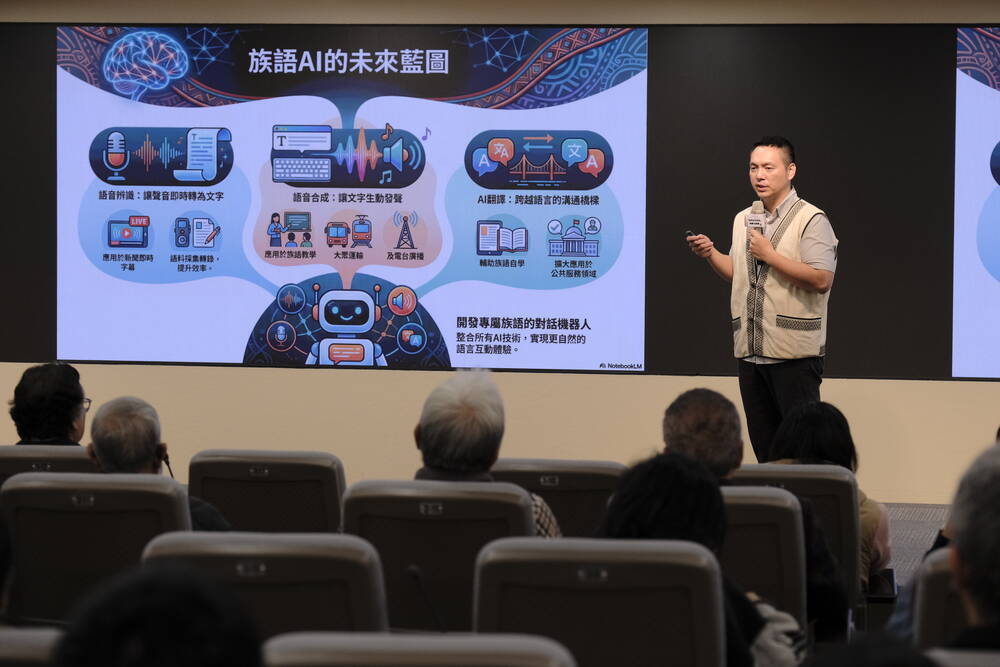
原語會執行長──許韋晟 Lowking Nowbucyang進行成果報告及系統介紹 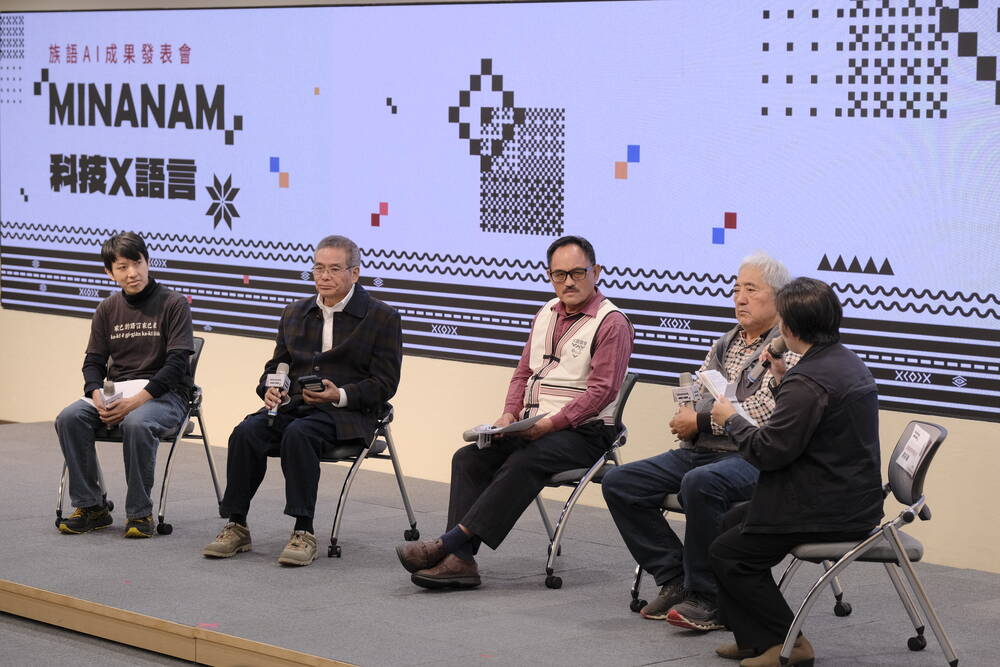
座談會分享 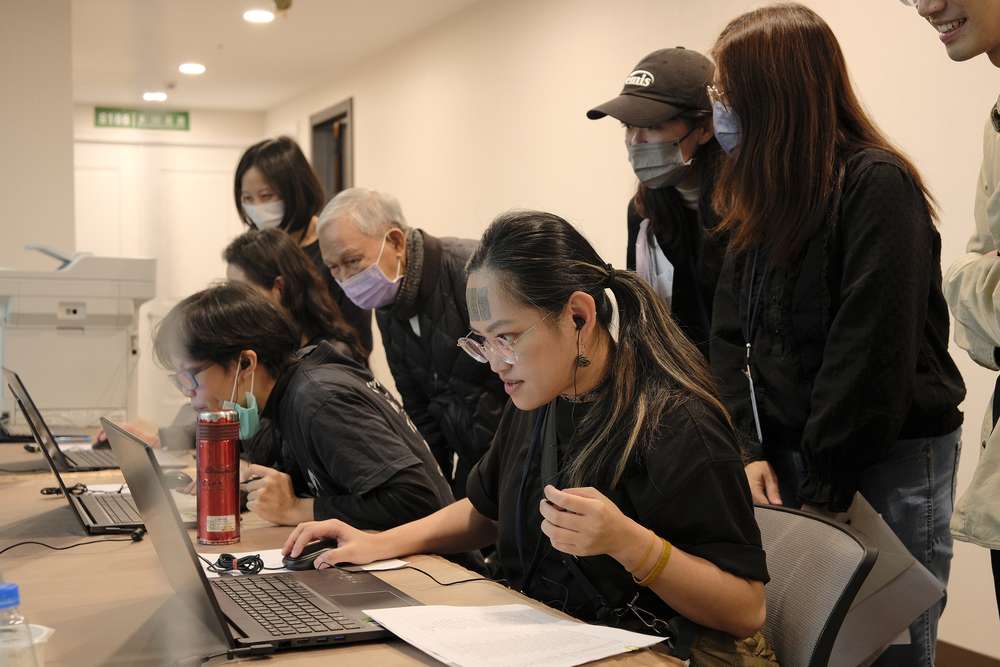
族語 AI 互動體驗區 
QA環節
常見問題
使用前想先知道的事
需要付費或申請帳號嗎?
四套系統都免費開放使用,直接開啟網頁即可操作,不需要申請帳號。
辨識或翻譯結果可以直接使用嗎?
由本網站系統產生出的內容皆可直接使用,不需另外向基金會申請授權。產生內容建議視作初稿,本網站系統為輔助應用工具,將結果用於正式教材、公文或出版品前,須再次確認內容是否正確。
模型的訓練語料有哪些?
包含族語 E 樂園語料、本計畫在專業錄音室錄製的三族朗讀與自發性語料、台灣聖經公會授權的族語聖經、三族語推組織提供的語料,以及計畫蒐集的各族語老師著作,翻譯系統的語料累計 84 萬句、3,289 萬字元。
可以申請這些語料做研究嗎?
可以,請至「語料申請」頁面填寫申請表單,說明用途與單位,由基金會審核後提供。
合作夥伴
匯聚各方之力,共織傳承之網
原語會自行研發,過程中積極與國內外學術單位、研究單位、各族族人合作,整合建置「可機讀族語語料庫」,讓族語 AI 的應用更多元。
感謝各族族人、行政院、立法院、教育部、原住民族委員會、國家高速網路與計算中心、財團法人台灣聖經公會及意傳科技有限公司一同為族語的未來努力。